Machine Learning (ML)
Maschine Learning (ML) - dt. maschinelles Lernen - ist eine zentrale Teildisziplin der Künstlichen Intelligenz. Ziel ist es, Systeme zu entwickeln, die aus Daten lernen, um Muster zu erkennen und daraus Vorhersagen oder Entscheidungen abzuleiten. Im Gegensatz zu wissensbasierten Ansätzen, bei denen Regeln explizit programmiert werden müssen, lernt ein ML-Modell diese automatisch durch Analyse großer Datenmengen.1
Die Entwicklung eines ML-Modells erfolgt durch das Training auf einer umfangreichen Datengrundlage. Dabei werden Algorithmen entwickelt, die aus den Daten Regeln extrahieren und diese in einem Modell speichern. Dieses Modell kann anschließend auf neue, bislang unbekannte Daten angewendet werden.2
Arten von Machine Learning
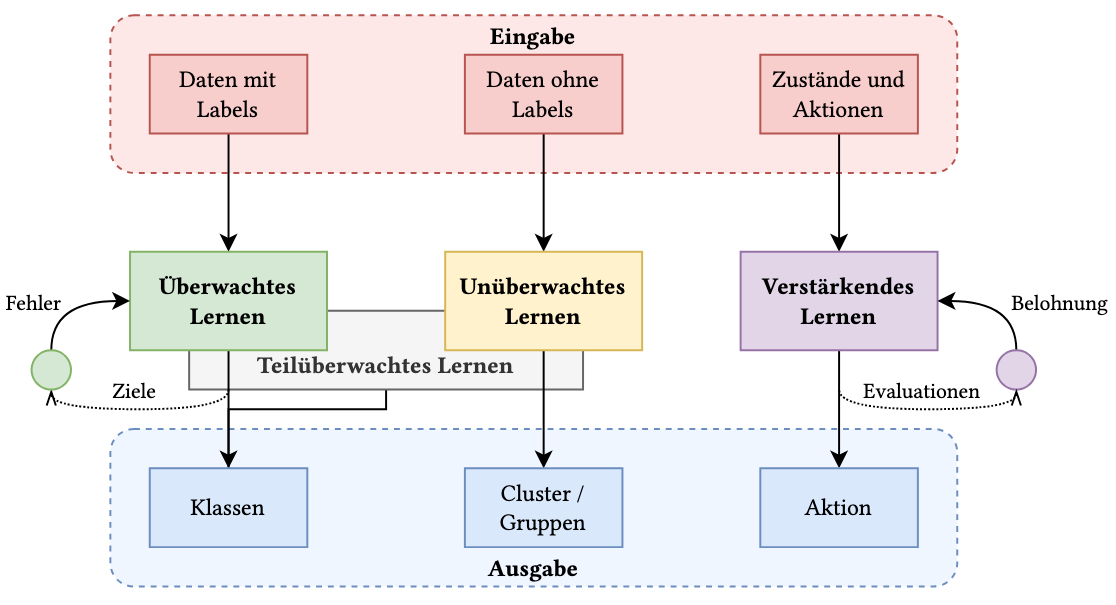
Im Folgenden werden vier Arten des maschinellen Lernens vorgestellt, die in der Abbildung unten nach Schneider (2025)3 veranschaulicht werden: (1) das überwachte Lernen, (2) das unüberwachte Lernen, (3) das teilüberwachte Lernen und (4) das verstärkende Lernen.
Überwachtes Lernen (Supervised Learning)
Hierbei werden dem Modell Datenpaare bestehend aus Eingaben und den dazugehörigen erwarteten Ausgaben (Labels) präsentiert. Ziel ist es, eine Funktion zu erlernen, die neue Eingabedaten möglichst genau klassifiziert oder vorhersagt.2 3
Unüberwachtes Lernen (Unsupervised Learning)
In diesem Fall erhält das Modell ausschließlich Eingabedaten ohne zugehörige Zielwerte. Es versucht, verborgene Strukturen oder Muster zu erkennen, etwa durch Clusterbildung oder Dimensionsreduktion.2 4
Teilüberwachtes Lernen (Semi-Supervised Learning)
Diese Lernform kombiniert überwachtes und unüberwachtes Lernen. Sie wird insbesondere eingesetzt, wenn nur ein kleiner Teil der verfügbaren Daten gelabelt ist, während der Großteil unbeschriftet vorliegt. In solchen Szenarien kommen Deep-Learning-Methoden zum Einsatz, die aus den unbeschrifteten Daten sogenannte Pseudo-Labels generieren. Ziel ist es, Eingabedaten möglichst präzise zu klassifizieren.2 5
Verstärkendes Lernen (Reinforcement Learning)
Dieser Ansatz basiert auf der Interaktion eines Agenten mit einer Umgebung. Der Agent trifft Entscheidungen (Aktionen), für die er je nach Ergebnis Belohnungen oder Strafen erhält. Durch diese Rückmeldungen lernt er eine Strategie zur Optimierung seiner Handlungen – eine sogenannte optimale Entscheidungspolitik.1 2 6
Michaeli, T., Kitzelmann, E., Seegerer, S., & Romeike, R. (2024). Lernen aus Daten. In U. Furbach, E. Kitzelmann, T. Michaeli, & U. Schmid (Hrsg.), Künstliche Intelligenz für Lehrkräfte (S. 25–38). Springer Fachmedien Wiesbaden. https://doi.org/10.1007/978-3-658-44248-4_3 ↩︎ ↩︎
Taulli, T. (2023). Grundlagen der Künstlichen Intelligenz: Eine nichttechnische Einführung (1. Aufl. 2022). Springer Berlin Heidelberg. https://doi.org/10.1007/978-3-662-66283-0 ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
Schneider, A. (2025). Large Language Models und Retrieval-Augmented Generation. Analyse und Potentiale ihres Einsatzes für die akademische Lehre im Software-Engineering. Pforzheim, Deutschland. ↩︎ ↩︎
Langer, J., & Schmid, U. (2024). Generative KI. In U. Furbach, E. Kitzelmann, T. Michaeli, & U. Schmid (Hrsg.), Künstliche Intelligenz für Lehrkräfte (S. 125–136). Springer Fachmedien Wiesbaden. https://doi.org/10.1007/978-3-658-44248-4_10 ↩︎
Yenduri, G., Ramalingam, M., Selvi, G. C., Supriya, Y., Srivastava, G., Maddikunta, P. K. R., Raj, G. D., Jhaveri, R. H., Prabadevi, B., Wang, W., Vasilakos, A. V., & Gadekallu, T. R. (2024). GPT (Generative Pre-Trained Transformer)—A Comprehensive Review on Enabling Technologies, Potential Applications, Emerging Challenges, and Future Directions. IEEE Access, 12, 54608–54649. https://doi.org/10.1109/ACCESS.2024.3389497 ↩︎
Lorenz, U. (2024). Verstärkendes Lernen. In U. Furbach, E. Kitzelmann, T. Michaeli, & U. Schmid (Hrsg.), Künstliche Intelligenz für Lehrkräfte (S. 81–97). Springer Fachmedien Wiesbaden. https://doi.org/10.1007/978-3-658-44248-4_7 ↩︎